Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

易輔科技
易輔科技
如果你在 2024 年跟人聊「本體」(Ontology),對方很可能以為你在談維根斯坦的語言哲學課,但到了 2026 年,本體重新出現在企業 AI 的核心討論裡。
原因很具體:Snowflake、Databricks 和微軟都開始把「業務語義」產品化,讓 AI Agent 不只看到資料表和欄位,還能理解客戶、訂單、產品、指標之間的業務關係。這代表一場重要的轉變:
企業 AI 的競爭,正從「誰的模型更強」,轉向「誰能把企業的業務語言、資料與行動規則,變成 Agent 可以可靠使用的共用上下文」。
Snowflake 在 2026 年 2 月 3 日宣布,Semantic View Autopilot 正式可用。這項服務用 AI 自動建立、優化與維護語義視圖,目的是讓 AI Agent 和 BI 工具共用同一套業務指標定義,減少不同部門對同一個 KPI 各說各話的情況。
Snowflake 的說法很直白:語義視圖要解決的,是 AI 回答商業問題時缺乏一致業務脈絡的問題。該公司宣稱,這能降低幻覺風險,並把語義模型的建立時間從數天縮短到數分鐘;但這是供應商的產品行銷宣稱,實際效果仍取決於企業既有資料品質、指標定義是否清楚,以及治理流程能否跟上。
Databricks 則在 2026 年 2 月 4 日宣布,Unity Catalog Business Semantics 正式可用,並將核心實作開源到 Apache Spark。它把指標、維度、關係與業務規則集中定義,讓 BI 儀表板、SQL 查詢、筆記本和 AI Agent 使用同一套受治理的業務定義。
這裡的關鍵產品是 Metric Views。企業可以把 KPI 定義一次,例如「活躍客戶」「毛利」「訂單轉換率」,之後儀表板、分析師與 AI Agent 都引用同一個定義。這解決的不是資料儲存問題,而是企業最常見的決策摩擦:同一個數字,行銷、財務和產品團隊各自算出不同版本。
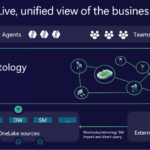
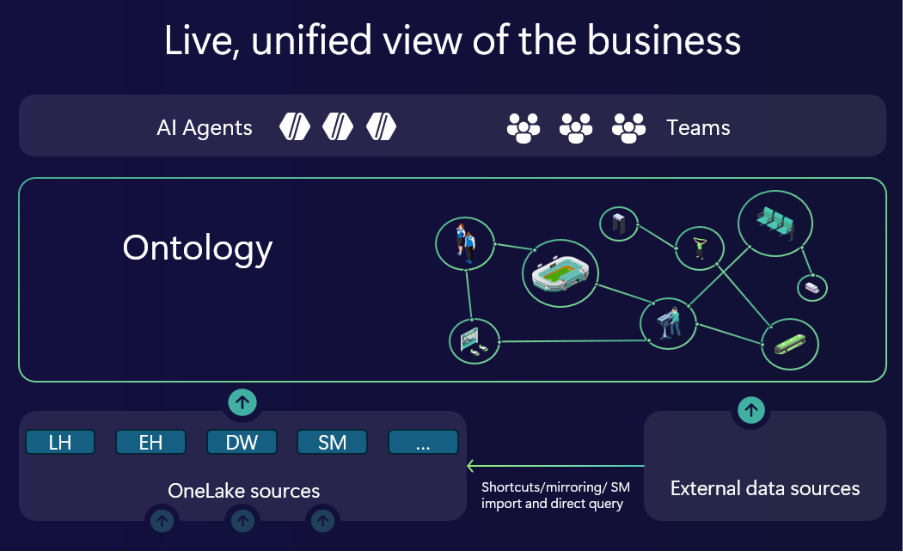
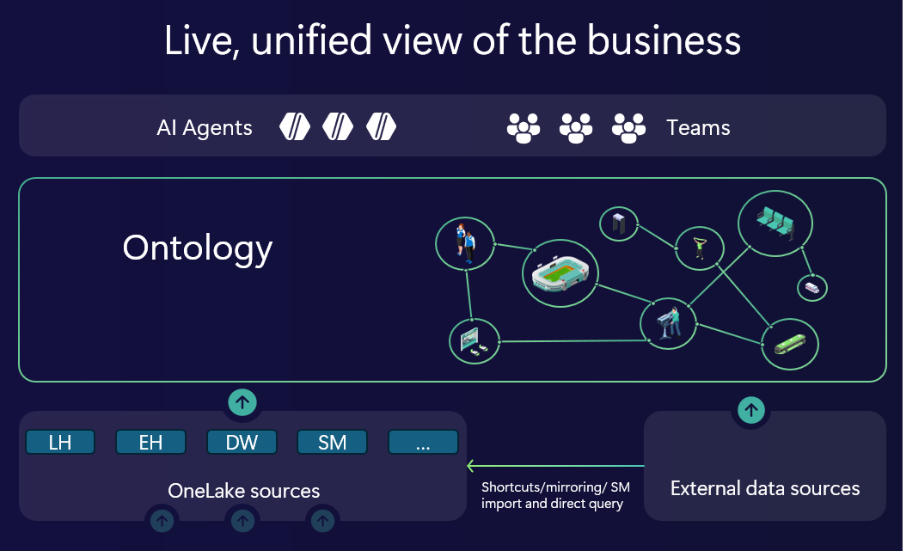
微軟則把本體放進 Fabric IQ。Fabric 的 ontology 目前仍是預覽功能,它定義企業中的重要概念,例如客戶、產品、資產、訂單與地點,並描述它們的屬性、關係、規則與指標,再把這些定義綁定到企業資料。
微軟在 Build 2026 表示,Fabric IQ 的本體將延伸語義模型,加入營運脈絡,定義業務實體、關係、屬性、規則與行動,並連接 Fabric Real-Time Intelligence 的即時訊號。 這使本體開始從「資料字典」走向「可執行的業務模型」:Agent 不只能回答「上季活躍客戶有多少」,還能根據預先定義的規則,判斷某個營運事件該觸發什麼行動。
這波本體熱潮的觸發點,是 AI Agent 開始進入企業工作流程。
傳統 BI 的問題是,人類分析師知道「留存率」在這家公司怎麼算、哪些資料可以信任、哪些欄位不能直接拿來做財務決策。但 AI Agent 若只拿到原始資料表,就必須自己猜測這些商業規則;猜錯時,它會產出看似合理、實際上不可用的答案。
本體和語義層要解決的,正是這個「上下文缺口」。它把企業的術語、指標、實體關係、資料來源與權限,變成 Agent 可以讀取的共用脈絡。Databricks 稱之為讓 Agent 和人類取得同一份「共享意義來源」;微軟則把它描述為讓人、應用程式與 AI Agent 使用相同詞彙與上下文的機制。
換句話說,本體的商業價值,不在於它本身很先進,而在於它讓 AI Agent 的答案可以被治理、被追蹤、被重複使用。當一個 Agent 回答「為什麼本月毛利下降」,它應該知道毛利的正式定義、可用的資料範圍、哪些指標有權限存取,以及下一步該查詢哪個系統。
這波討論最容易混淆的地方,是「語義層」和「本體」常被當成同一件事。
| 概念 | 主要解決的問題 | 典型能力 | 目前成熟度 |
|---|---|---|---|
| 語義層 | 讓不同工具使用同一套指標與維度 | KPI 定義、維度、同義詞、格式、權限 | 已進入正式可用階段 |
| 本體 | 讓系統理解業務實體、關係、規則與行動 | 實體、關係、規則、資料綁定、Agent 上下文 | 多數仍處於預覽或早期階段 |
| AI Agent | 把業務問題轉成查詢、分析或行動 | 讀取語義上下文、產生查詢、執行工作流程 | 依賴語義層與本體的品質 |
所以,Snowflake 的 Semantic View Autopilot,比較接近「自動化語義層」;Databricks 的 Unity Catalog Business Semantics,是先把受治理的指標與維度做好;Fabric 的 ontology,則更明確地把實體、關係、規則與行動納入同一個模型。
這不代表本體已經取代語義層。比較合理的判讀是:
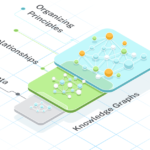
語義層是本體的基礎,本體則是把語義層延伸到營運決策與 Agent 行動的下一層。
對這波熱潮最尖銳的反問是:本體在 1990 年代和語義網時代都曾經被寄予厚望,為什麼這次不會重演失敗?
第一個反駁是事實反駁。過去的本體專案常失敗,因為企業必須先人工建立龐大、精確且長期維護的知識模型,投入成本高、回報週期長。這次不同之處在於,AI 可以協助從既有資料、使用紀錄與文件中草擬實體、關係與綁定;Snowflake 和微軟都把 AI 輔助建立與維護列為產品能力。
但這個反駁也有極限。AI 可以降低建模成本,卻無法替企業決定「什麼才是正確的業務定義」。如果財務、法務、營運與產品團隊對同一個指標沒有共識,AI 只會更快產生一套看似一致、實際上錯誤的語義模型。
第二個反駁是商業反駁。企業未必需要一個橫跨全公司的巨型本體;大多數團隊可能只需要把十幾個關鍵 KPI、核心客戶與產品概念定義清楚。若供應商把本體包裝成必須全面導入的平台能力,客戶可能會因為導入成本太高而卻步。
比較可行的路徑,是從高價值、高爭議、高重複使用的業務概念開始,例如營收、毛利、活躍客戶、供應商風險或庫存週轉。先讓一個 Agent 在受控範圍內使用同一套定義,再逐步擴大,會比一開始就建立企業級知識圖譜更務實。
第三個反駁是方法論反駁。目前多數發布仍集中在「讓 Agent 理解業務」;但理解業務和安全地採取行動,是兩件難度完全不同的事。微軟雖然把規則與行動納入本體設計,也提到作業 Agent 可以依據本體評估條件並採取行動,但這類能力仍需要人類審核、權限控制與可回溯的執行紀錄。
因此,
本體能否真正復活,關鍵不在於展示時 Agent 能否回答問題,而在於企業是否願意把「業務定義、資料品質、權限與行動授權」當成長期治理工程來經營。
對資料與 AI 團隊來說,接下來該停止做的,是把 AI Agent 直接接上原始資料表,然後期待它自己理解公司語言。該開始做的,是先建立少數可被多個團隊引用的指標定義、資料字典與實體關係。
一個可執行的檢查清單是:
本體重新變熱,證明企業 AI 已經進入下一個戰場:
誰能把散落在報表、資料庫、文件和流程裡的業務知識,變成 Agent 可以安全使用、也容易被治理的共用上下文,誰就能讓 AI 從展示工具,變成真正進入營運決策的系統。