Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

易輔科技
易輔科技

2023 年,知識圖譜常被視為大模型時代的舊技術:建置昂貴、本體工程繁重,也難以說明自己相對向量資料庫的價值。
到了 2026 年,Altair、Digital Science 與 Oakley Capital 卻先後把資金與資源投向知識圖譜、語義資料與語義層技術。這三筆交易共同指向一個判斷:
企業 AI 的競爭正在從「誰的模型會說話」,轉向「誰能讓模型在正確的業務脈絡下,使用可稽核的資料」。
三筆交易的規模與性質不同,但動機高度一致。
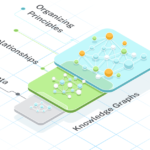
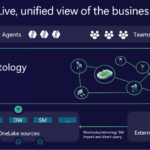
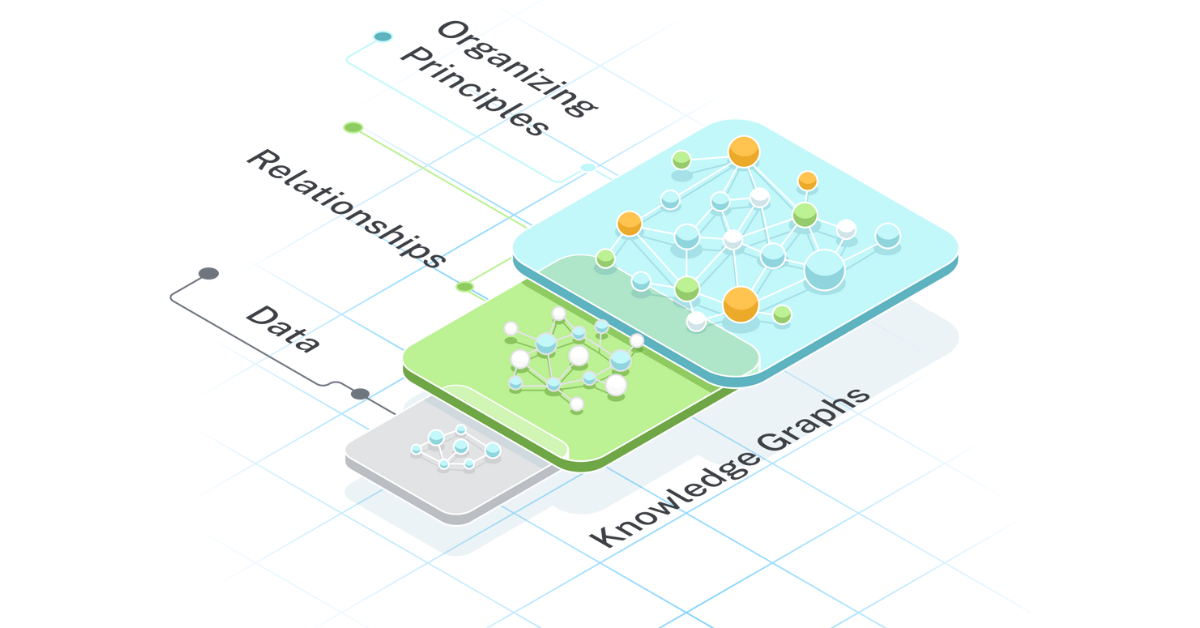
這些交易背後,不是單純的圖資料庫投資潮,而是企業開始為 AI 建立一個新的中間層:語義層。它把分散在資料倉儲、資料湖、業務系統與文件中的資訊,轉換成具備業務脈絡、關係與治理規則的知識結構,讓 AI Agent 能夠查詢、推理,並留下可追蹤的依據。
傳統知識圖譜最常被批評的地方,是建置成本太高。企業往往得先花數月甚至數年梳理本體、清洗資料、建立實體對應,才能讓圖譜真正支撐業務查詢。這讓它長期被視為金融風控、國防、生命科學等少數高價值場景的工具。
Altair 收購 Cambridge Semantics,代表產品形態正在改變。Cambridge Semantics 的技術會整合進 Altair RapidMiner,補足知識圖譜、資料治理、資料虛擬化與資料探索能力;Altair 執行長 James R. Scapa 表示,知識圖譜是資料編織的關鍵組件,能在正確時間把正確資料交給正確的人。
知識圖譜是資料編織(Data Fabric)的關鍵部件。它們在正確的時間,把正確的數據送到正確的人手裡。我們相信 Cambridge Semantics 為擁有海量資料與深度問答需求的企業,提供了業界最快、最具擴展性的知識圖譜。
此外,知識圖譜對於生成式 AI(Generative AI)應用的成功至關重要,因為它們提供了將生成式 AI 模型『落地(Grounding)』所需的業務上下文(Business Context),進而消除幻覺並顯著提升回答質量。
—— James R. Scapa(Altair 創辦人兼 CEO)
這裡的商業意義很具體:知識圖譜不再被當成一座必須單獨建置、單獨維運的圖資料庫,而被封裝成資料編織與分析平台中的語義引擎。企業可以在既有資料架構上建立業務脈絡,讓資料科學、BI、MLOps 與 AI 應用共用同一套語義定義。這降低的是採用門檻,也讓知識圖譜從專案型技術,往平台化能力移動。
2023 年向量資料庫與 RAG 快速走紅時,市場一度認為「向量相似度加提示詞」就能解決大部分企業知識檢索問題。但實務很快暴露限制:向量檢索擅長找出語意相近的片段,卻不容易處理多層關係、權限、版本、因果與跨系統的業務規則。
Digital Science 收購 Ontopic,正好補上這一塊。Ontopic 的核心是 Virtual Knowledge Graph 與 Ontology-Based Data Access:企業不必先把資料複製或遷移到圖資料庫,就能把語義邏輯映射到既有關聯式資料庫上。Digital Science 表示,這種做法能讓使用者直接從既有資料來源建立與存取知識圖譜,避免昂貴且耗時的資料轉換。
Ontopic 執行長 Peter Hopfgartner 的說法更直接:結合虛擬化技術與 metaphactory,公司要提供的是一個可讓 AI Agent 在即時、分散資料上推理的語義層,並強調「零複製」。這句話的關鍵在於,它把知識圖譜從資料整合工具,重新定位成 AI Agent 存取企業事實的介面。
我們的客戶一直反映需要更敏捷的方法來將碎片化的資料轉化為可執行的知識。Ontopic 專精的虛擬知識圖譜技術與本體建構資料存取(ODBA),能讓企業在『不複製/不遷移底層資料』的前提下,直接將圖譜語義邏輯映射到現有的關係型資料庫,這大幅加速了企業邁向企業級 AI 與語義網的客戶旅程。
—— Sebastian Schmidt(Digital Science 企業端執行副總裁)
不過,這裡必須保留一個重要限制:GraphRAG 能提升回答的脈絡性與可追溯性,卻不能保證 AI 不會出錯。若本體設計錯誤、資料來源過期、權限定義不完整,圖譜反而會把錯誤的業務規則放大。語義層的價值,來自治理與維運,而非單純接上大模型。
第三筆交易改變的是商業模式判斷。Oakley Capital 宣布投資 Graphwise,並指出該公司擁有超過 200 家藍籌客戶(龍頭地位、財務實力雄厚、商譽極佳且經營極為穩定的大型知名企業或機構),年度經常性收入每年有機成長超過 30%。Graphwise 由保加利亞的 Ontotext 與奧地利的 Semantic Web Company 於 2024 年合併而成,主打 RDF 知識圖譜與語義層技術。
這些數字仍應謹慎看待:它們來自投資方與被投資公司共同發布的公告,並非公開財報;「超過 30%」也未說明統計期間、客戶留存率與 ARR 的認列口徑。但即使打折來看,它仍傳遞出一個重要訊號:知識圖譜已經有機會從一次性客製專案,走向可複製、可擴張的軟體訂閱業務。
Oakley 創辦人 Peter Dubens 的理由也很清楚:AI 讓受信任且治理良好的資料變得更重要,而 Graphwise 的平台正是為此設計。這代表資本看重的,未必只是圖譜技術本身,更是它在金融服務、生命科學與公部門等高監管產業中的可稽核性、資料治理與合規能力。
AI 正在改變每個組織的運作方式,但這也使得『受信任、且具備良好治理的數據』變得比以往任何時候都更加重要。Graphwise 打造了一個卓越的平台來解決這個挑戰,並展現了令人矚目的增長。我們將協助他們在全球市場進行商業擴展與策略性併購。
—— Peter Dubens(Oakley Capital 創辦人兼管理合夥人)「當初我們合併成立 Graphwise 的目標很簡單:解決阻礙企業 AI 發展的最根本數據挑戰。AI 正在變革行業,但模型的可靠性完全取決於餵給牠的數據。 Oakley 的加入將加速我們成為 AI Agent 語義層基礎設施(Semantic Layer for AI Agents)的願景。」
—— Rick Crane(Graphwise 高階主管)
這三筆交易對企業的啟示,並非「立刻導入知識圖譜」。更實際的判斷是:
當 AI Agent 開始接觸跨部門、跨系統、跨權限的企業資料時,企業是否已經有一層可共享的業務語義與資料治理規則。
問自己三個問題:
若答案都是否定的,企業即使部署了最先進的 LLM,仍會卡在同一個地方:模型很會表達,卻不知道企業真正允許它知道什麼、能做什麼、該向誰負責。
我的判斷是,未來兩到三年,知識圖譜不會取代向量資料庫或 LLM,但會在需要高可信度、可稽核性與複雜業務推理的企業 AI 場景中,取得難以取代的位置。它的勝負關鍵,不在於圖譜是否「更聰明」,而在於能否降低建置與維運成本、能否與既有資料架構共存、能否把治理規則變成 AI 可執行的約束。
這條路仍有可能失敗。若企業持續把本體建模當成大型顧問專案、若語義層無法即時同步業務變化、若供應商只賣圖資料庫卻無法解決資料虛擬化與治理問題,知識圖譜仍可能退回小眾技術市場。
反過來說,若 Graphwise、Ontopic 這類公司能把語義建模自動化、把虛擬化做成標準能力,並讓 AI Agent 直接呼叫可治理的企業事實,知識圖譜就會從技術配角,變成企業 AI 的基礎設施。
大模型負責表達,知識圖譜負責讓表達有依據。這三筆交易真正押注的,正是後者。