Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

Kirkland & Ellis 與 Palantir 合作推出 Fund Formation Engine,真正值得注意的地方是,全球營收最高的律師事務所開始把最資深律師的判斷、客戶關係與交易慣例,轉成一套可治理、可累積、可複用的組織資產。這是一場把「人的經驗」變成「企業資料結構」的實驗,基金設立只是第一個測試場。
Kirkland 投入約 5 億美元的 AI 計畫,並與 Palantir 合作打造私募股權募資平台。這筆投資的重點不在於讓律師更快起草文件,而在於把基金設立過程中分散在律師腦中、檔案櫃與電子郵件裡的判斷,集中成一套帶有權限、可推理、可持續更新的私有系統。
這個案例真正值得法律科技圈、知識圖譜圈與企業 AI 團隊注意的,是一個更普遍的問題:當基礎模型越來越便宜、越來越通用,企業真正難以複製的資產,會不會從「擁有最好的模型」轉向「擁有最難被外部化的判斷與資料結構」?
我的判斷是:會。而且 Kirkland 正在示範這條路。
私募基金設立聽起來像大量法律文件工作:基金合約、認購文件、side letter、最惠國待遇條款、費用結構、投資人盡職調查、合規文件。這些工作的確可以靠 AI 加速,但若只把它理解成「讓 GPT 幫忙寫合約」,就會錯過真正的難點。
基金設立的敏感之處,在於每位有限合夥人拿到的條件未必相同。有人取得較低的管理費,有人拿到共同投資權,有人擁有治理席位,也有人取得特定情形下的退出或豁免權利。當某位投資人享有最惠國待遇條款,一旦其他投資人的條件外洩,就可能引發一連串重新協商。
真正的風險,往往不在於某份文件被看見,而在於「誰拿到了什麼條件」這張關係圖被看見。
這就是為什麼這個場景特別適合 Ontology。Palantir 的 Ontology 把企業資料對應到真實業務物件,例如投資人、基金、條款、承諾金額、費用、關係與權限,讓系統能夠處理物件之間的關係,而不只是對文件做關鍵字檢索。
換句話說,Kirkland 要解決的問題,並非「如何更快產出文件」,而是「如何在極度分散、高度敏感、且規則持續變動的協商環境裡,讓對的人看見對的資訊」。
Kirkland 擁有超過 1,000 名基金律師,並服務規模龐大的私募資本市場客戶。這些律師每天處理的,包含條款如何談、市場行情如何變、投資人如何反應、哪些安排曾經被接受、哪些安排曾經被否決,以及哪些妥協最後成為可複用的先例。
這些知識原本主要存在於個人經驗、內部郵件、舊檔案、口頭傳承與資深合夥人的判斷裡。它們很有價值,卻很難被新人直接使用,也很難隨著人員流動而完整保留。
Fund Formation Engine 的意義,在於把這些分散的判斷,逐步沉澱到一個共同的工作系統。Kirkland 管理合夥人 Erica Berthou 將它描述為一個能集中並累積資深律師專業判斷的基金設立引擎。
這句話值得認真看待。它代表 Kirkland 想做的,可能已經超越「AI 增強律師生產力」,進入「把律所的判斷力資本化」。
這裡的資本化,指的是把原本依附在個人身上的經驗,轉成企業可以持續使用、更新、授權與治理的資產。當一位資深合夥人離開,他的部分判斷仍可能留在系統裡;當一位新進律師處理類似交易,系統能提供的不只是範本,還包括過去類似情境下的市場慣例、風險點與協商邏輯。
這才是這筆投資最值得追蹤的地方。
如果目標只是產出法律文件,Kirkland 有很多選擇。Harvey、Legora,或直接使用大型模型供應商的 API,都可能比自建系統更快見效。基金設立雖然複雜,卻也未必需要 Palantir 等級的企業平台。
Kirkland 選擇 Palantir,合理的解釋是:它要處理的問題,已經超出文件生成,進入資料架構、權限治理與流程整合。
Palantir 的 AIP 與 Ontology,讓企業能把資料、業務邏輯、權限與工作流程綁在同一個系統裡。對 Kirkland 來說,這代表它可以把客戶、基金、條款、文件版本、審批流程、合規規則與律師判斷,放在同一個可操作的結構中。
這也解釋了為什麼 Kirkland 不只採購現成工具。該公司被報導正在招募具備在地端 GPU 環境經驗的 AI 基礎設施主管,職責包括設計與管理 GPU 叢集、Azure AI 與機器學習服務,並建立安全、受治理的實驗環境。這些跡象顯示,Kirkland 可能有意以自有資料微調開源模型,讓核心能力留在內部。
這裡的關鍵差別是:租用一項能力,與擁有一套能持續累積判斷的系統,是兩件事。
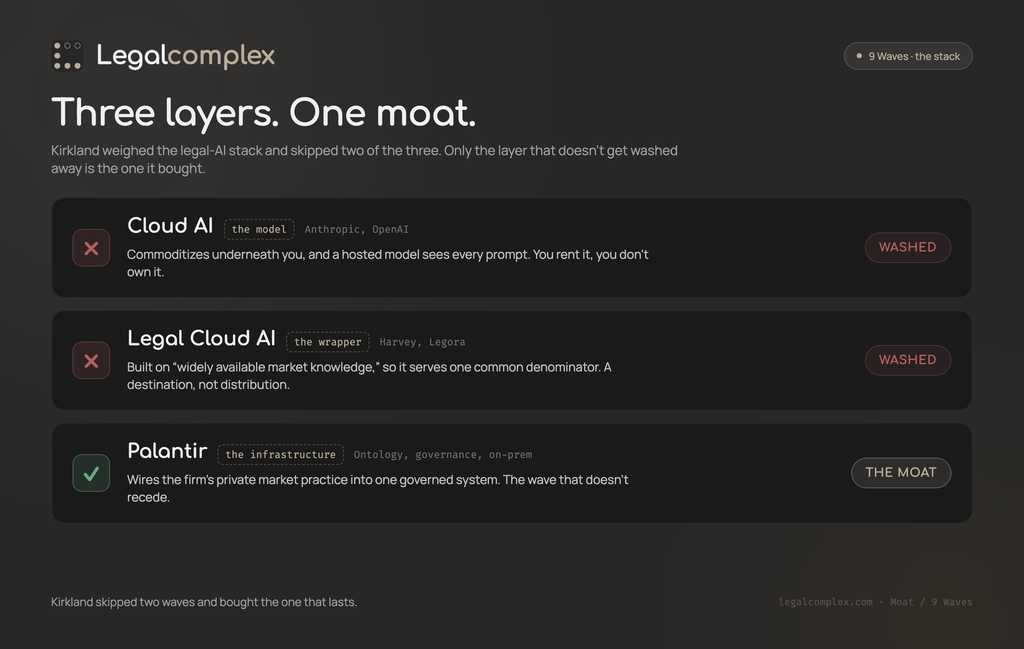
這個案例可以用一個簡單的三層架構來理解。
| 層級 | 代表 | 核心能力 | 商業弱點 |
|---|---|---|---|
| 基礎模型層 Cloud AI | OpenAI、Anthropic、Google | 通用語言理解、推理與生成 | 能力快速商品化,客戶可替換供應商 |
| 法律 AI 包裝層 Legal Cloud AI | Harvey、Legora 等產品 | 法律介面、工作流、文件生成 | 若缺乏專屬資料與流程整合,容易被整合或取代 |
| 企業判斷基礎設施層 Palantir | Kirkland 加 Palantir 的組合 | 私有資料、Ontology、權限治理、內部流程 | 建置成本高,但一旦形成,較難被外部複製 |
基礎模型層的價值會持續存在,但它本身很難成為單一企業的長期護城河。模型會降價、會被替換,客戶也會隨著成本、效能與合規需求更換底層供應商。
法律 AI 包裝層則面臨另一個問題:若產品主要建立在公開法規、公開判例與通用模型之上,競爭者也能取得相近的基礎能力。產品可以做得很好用,但若沒有客戶私有資料、深度流程整合或獨特判斷累積,它更容易被更大的平台收購、整合或取代。
Kirkland 選擇的,是第三層。
它把自有資料、內部判斷、Ontology、權限治理與可能的在地端部署,綁成一個整體。這個組合的價值,來自 Kirkland 已經擁有的市場實務,也來自它願意把這些實務變成可營運的系統。
這道護城河至少由三個部分組成。
第一是私有交易資料。Kirkland 在大量基金交易中累積的條款、協商紀錄、投資人偏好與市場慣例,並不存在於公開語料裡。這些資料只在事務所自己的檔案、工作流程與律師判斷中。
第二是本體化的組織知識。把資料放進系統,只是第一步。真正困難的,是把「哪些條款適合哪類基金」、「哪些投資人通常要求什麼」、「哪些風險曾經如何處理」,轉成可查詢、可推理、可傳承的業務物件與關係。
第三是治理能力。基金設立不能讓所有人看見所有資料。每位有限合夥人只能看到自己的條件,內部律師也只能依職務與授權存取特定範圍。這需要物件層級的權限設計,而非單純的資料夾分類或文件加密。
這三項加起來,才構成 Kirkland 的優勢。模型可以租,介面可以買,但「把自家市場判斷結構化成可治理系統」的能力,很難直接外購。
不過,這套系統仍有兩個容易出問題的地方。
第一個隱憂是法源資料。法律 AI 遲早需要處理成文法、判例、法規與監管要求。這些內容多屬公開資料,Kirkland 原則上可以把它們放進自家系統,而不必然外洩客戶資訊。真正的風險,往往出現在法源資料庫之上的編輯層,例如 headnotes、引證工具,或「這條法律現在還有效嗎」的判斷服務。若查詢過程把客戶脈絡帶進外部供應商,機密資訊就可能跟著外流。
第二個隱憂是模型本身。若 Kirkland 使用 OpenAI、Anthropic 或 Google 的託管模型,每一次提示詞都可能包含有限合夥人名稱、承諾金額、條款內容或 side letter 細節。即使 Palantir 不接觸客戶資料,也不代表模型供應商的部署與資料處理安排完全沒有風險。
這正是為什麼在地端 GPU、開源模型微調與內部治理,可能才是整個計畫中最關鍵的一環,而不只是技術細節。
Kirkland 選擇基金設立作為第一個實驗場景,並非偶然。這是一個相對封閉的領域:先例主要來自事務所自身、條款內容不會公開、市場參與者有限,而且資深律師的判斷可以部分替代外部法律資料庫的編輯層。但若未來擴展到訴訟、公開研究或其他高度依賴外部法源驗證的領域,這道縫隙就會重新打開。
這筆合作也透露了一個更重要的產業訊號:
市場頂端的大型買家,正在選擇自建基礎設施,而不只是採購現成產品。
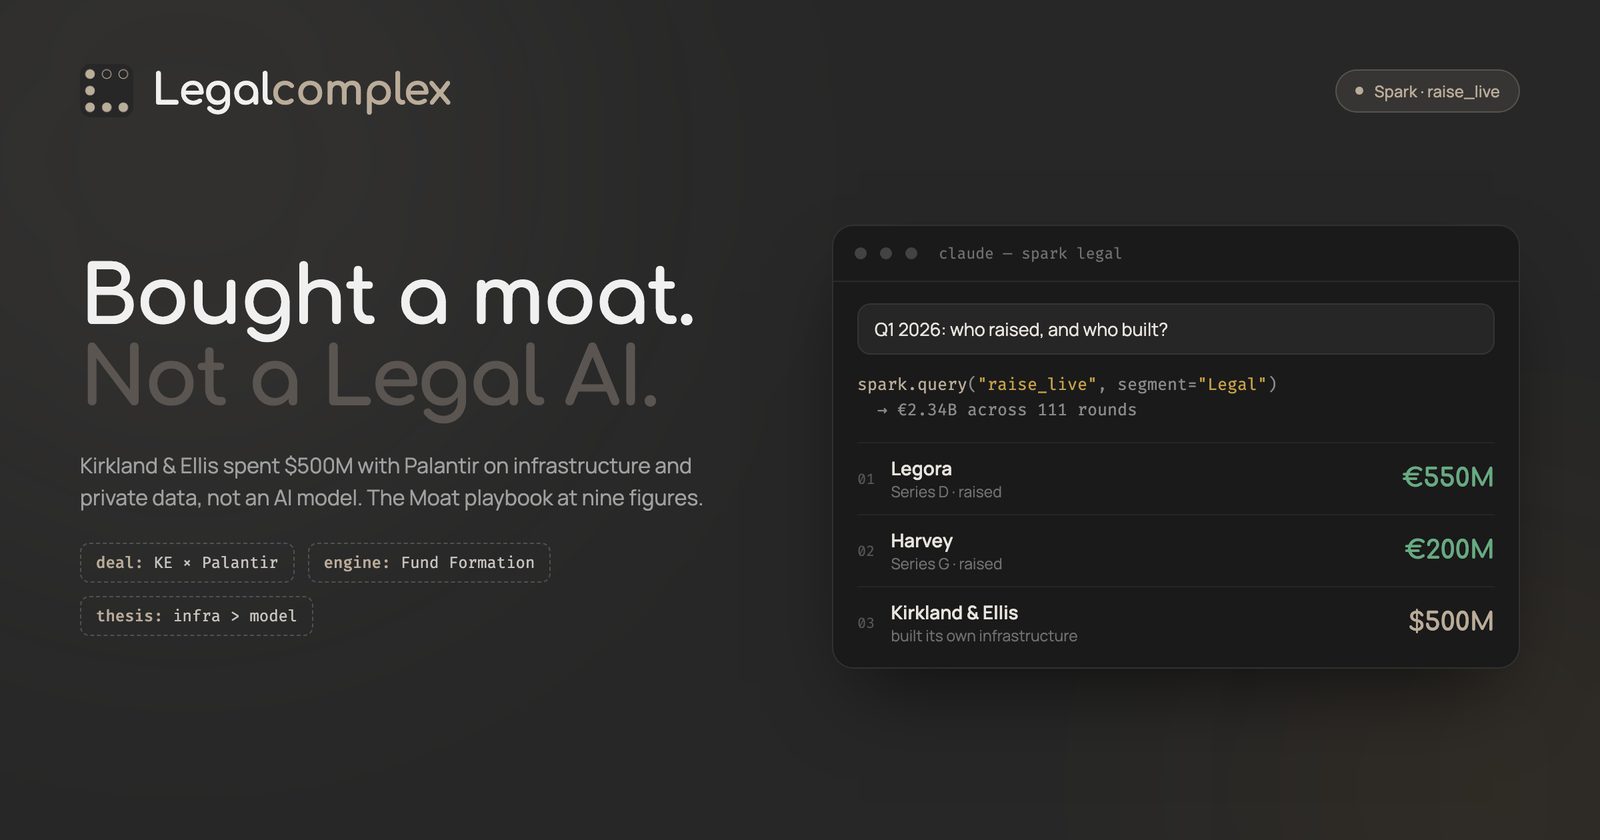
Legalcomplex 的 Spark 資料集顯示,2026 年第一季法律領域在 111 輪融資中募得 23.4 億歐元,是自 2024 年第一季 34.2 億歐元高峰以來最強的單季表現。Legora 與 Harvey 也在 3 月相隔兩週內,分別完成 5.5 億歐元 Series D 與 2 億歐元 Series G 融資。資金並不缺乏,問題是資金最終流向哪一層。
從併購動態來看,許多法律 AI 公司正被併入更大的平台或產品組合,例如 Thomson Reuters 收購 Noetica AI、Legora 收購 Qura、Doctrine 收購 Maite、Filevine 收購 Pincites、LawVu 收購 ClauseBase。這似乎顯示,所謂「模型之上的應用層」正在被整合,而真正握有私有資料、客戶關係與營運流程的機構,則更傾向把關鍵基礎設施握在自己手裡。
這不代表通用法律 AI 產品沒有價值。對多數律所而言,採購成熟工具仍可能比自建更有效率。但對 Kirkland 這類規模、資料密度與客戶結構都極端特殊的機構來說,現成工具能解決的,往往只是效率問題;它們真正想解決的,是如何把自身最稀缺的資產,也就是市場實務與判斷力,變成可規模化、可防禦的系統。
最直接的批評是:拿掉企業級語彙,這套系統可能只是知識管理、範本庫、流程自動化,加上 Palantir 的品牌與工程能力。
這個批評有其道理。Kirkland 選擇 Palantir,部分原因可能確實來自行銷、採購慣性、既有關係或企業級安全需求,未必全是技術必然性。
但若一套系統真的能精細管理權限、把資深律師的判斷嵌入工作流程,並讓事務所的市場實務持續累積,它就不只是貼上 Palantir 商標的知識管理工具。問題在於,外界目前能看到的,多半是產品定位與少數公開說法,還不足以證明它在實際交易中的表現。
Kirkland 與 Palantir 的合作,未必能永久阻止 Palantir 為其他大型律所建立類似系統。若這類私有平台逐漸普及,先發優勢會遞減,護城河也會從「獨家基礎設施」變成「基本配備」。
這是合理的風險。Kirkland 目前擁有的,可能是一段時間內的領先,未必是永久性的結構性優勢。真正的差異,最後仍取決於它能否持續累積資料、維持治理能力,並讓律師真的願意把判斷放進系統。
這是最誠實的一個反問。當一篇文章已經以「護城河」、「浪潮」與「私有 AI 設備」作為主要概念,任何大型合作案都很容易被塞進同一套敘事。
檢驗標準,應該是這個框架是否能在事前指出幾件事:企業應該優先投資基礎設施而非單純採購模型;應該先選擇封閉性高、資料敏感、且判斷難以外購的業務場景;應該把資料治理與模型部署視為核心,而非附屬功能。
Kirkland 的做法確實符合這些條件。但這仍是一個正在進行中的實驗,尚未被市場充分驗證。
法律專業對壟斷與獨立性特別敏感。當一家規模最大的律師事務所,同時成為關鍵法律科技平台的擁有者,競爭對手是否願意把最敏感的交易資料,放進競爭者的系統?這不只是技術問題,也是市場信任與職業倫理問題。
Kirkland 確實買到了兩項相對耐久的資產:私有資料與營運基礎設施。它也把這些資產包裝成一個強調資料主權與內部治理的私有系統,並選擇從最封閉、最依賴關係與判斷的基金設立業務切入。這是一個相當漂亮的策略布局。
但真正的問題還沒有答案:一個高度重視獨立性的市場,是否願意接受最好的工具,來自其中最大的玩家?
若三個答案都是肯定的,那目前可能已經接近 Kirkland 正在嘗試的事。若答案多數是否定的,則可能仍停留在模型應用層,而
模型應用層最大的風險向來都是:別人很快也能做出一個很像的東西。