Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

易輔科技
易輔科技
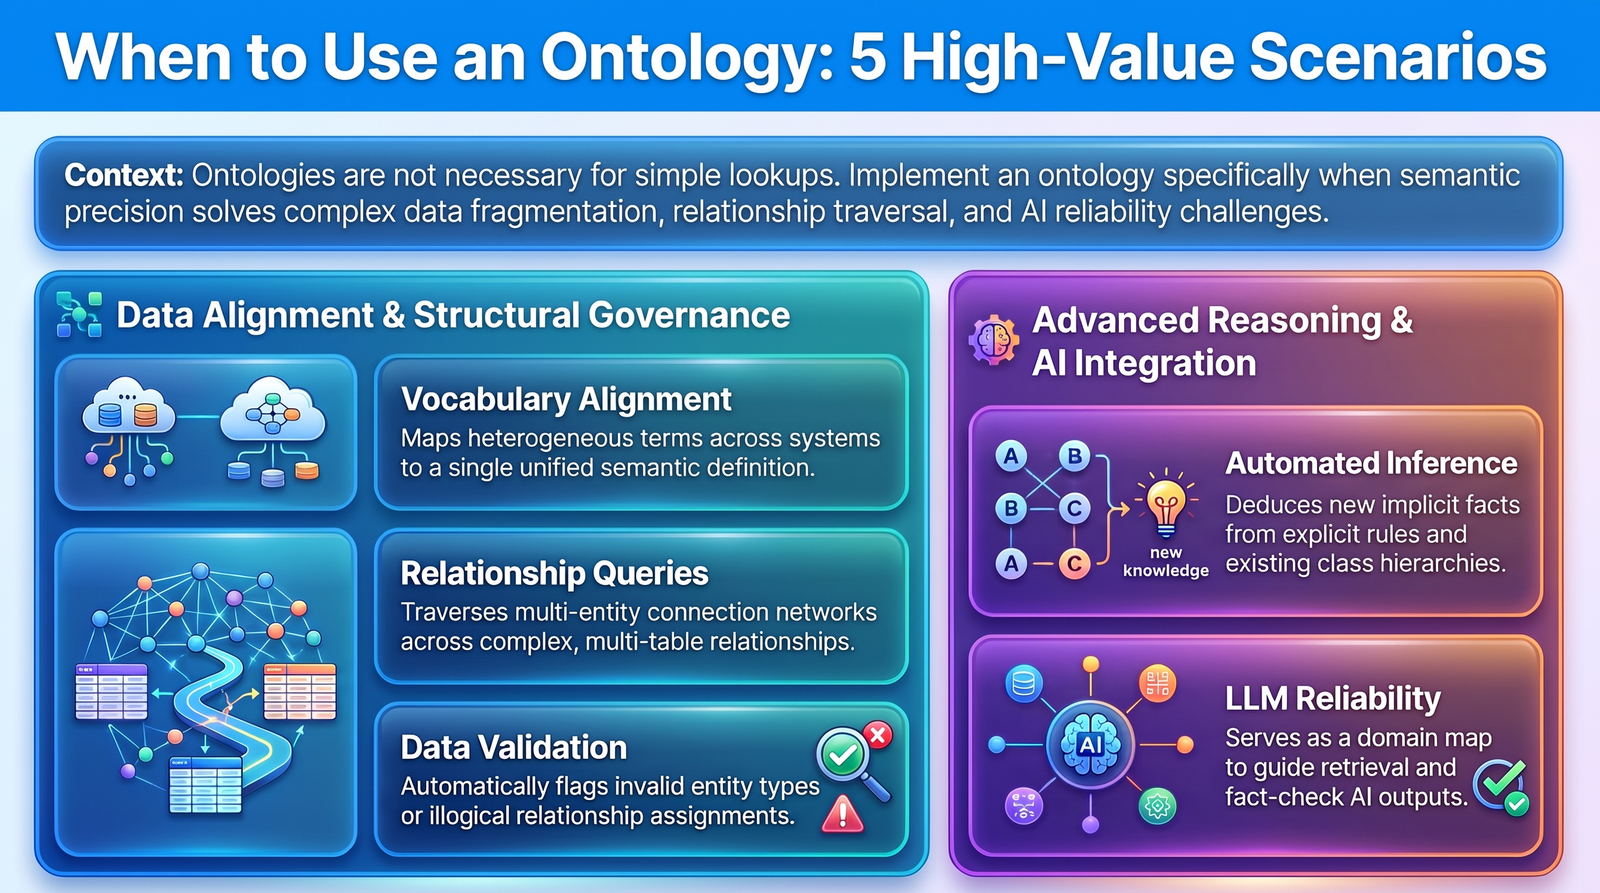
企業應該優先把本體(Ontology)用在理解錯誤會造成實際損失的業務。單純查一筆訂單、讀取一份商品資料,通常不需要額外建立本體。值得投入的地方,是同一個名詞反覆引發爭議、答案藏在多層關係裡,或一個不合邏輯的判斷就可能影響風險決策。
導入前,先問一個問題:把意思定義得更清楚,究竟能讓哪個決策變快,或擋下哪種錯誤?
這個問題答不出來,本體專案就缺少值得驗證的商業目標。
本體是一套明確描述領域概念與關係的模型。它會定義有哪些對象、對象如何分類,以及彼此之間可以成立哪些關係。W3C 的本體語言規範,也以這些定義作為知識表達與邏輯推理的基礎。
以企業裡的客戶資料為例,業務部關心簽約對象,財務部關心付款單位,客服則需要知道實際使用者。這些對象可能相同,也可能分屬不同公司。
如果系統只保留一個客戶欄位,三個部門即使交換了資料,仍然可能各自解讀。
本體要處理的,就是把這些差異明確寫出來。簽約方是誰、誰負責付款、誰有權使用服務,應該各自對應到什麼角色與關係。後續查詢和判斷,才有一致的依據。
這也說明,本體與表格或 JSON 並不互斥。表格和 JSON 可以承載資料;本體補上的,是這些資料應該如何被理解。
可以把導入判斷整理成一個三種錯誤成本框架:歧義成本、關係追查成本,以及邏輯錯誤成本。
這三種成本越明確,就越容易知道本體要解決什麼,也越容易檢驗投入是否值得。
歧義最常出現在跨部門或跨系統合作。
同一個詞,可能有不同意思;不同詞,也可能指向相同概念。結果是每次整合資料,都要重新確認欄位定義,甚至等到報表對不起來,才發現雙方從一開始就在談不同的東西。
詞彙對齊的價值,就在於讓這些對應關係可以被重複使用。
不過,對齊之前必須先確認概念是否真的相同。原始素材中的 fund provider、asset manager 與 management company,不能只因為都與基金有關,就直接合併成同一個角色。建模時應先確認各自的業務定義;確實等義的名稱才做對應,有差異的角色則保留區別。
本體建模最需要避免的,就是為了統一名稱,把重要的差異一起抹掉。
如果一個領域長期需要靠人解釋欄位,或同一份資料經常得到互相衝突的解讀,就值得先盤點歧義造成的重工。
有些問題的困難,在於答案取決於一整條關係路徑。
假設一家供應商停工,採購人員想知道哪些訂單會受影響,就需要從供應商追到零件,再找到使用該零件的產品,最後連到尚未交付的訂單。
資料可能早已存在,查詢仍然困難,因為每一段關係都需要被正確理解。
本體可以明確定義供應商、零件與產品等概念,以及供應、使用等關係,讓查詢有一致的語義基礎。實際沿著關係尋找答案,仍需要查詢工具與適當的資料結構配合。w3+1
也要注意,多表查詢本身不足以構成導入理由。關聯式資料庫也能處理複雜關聯。
更值得評估的情況是,關係跨越多個系統,每個系統對關係的定義又不一致,導致團隊每次回答問題,都得重新確認資料究竟怎麼連。
此時,應該衡量的是從提出問題到得到可信答案,需要多少人工追查。
資料能順利匯入,不代表它符合業務規則。
假設一筆紀錄填了付款單位,也填了合約編號,但付款單位與該合約之間沒有符合要求的關係。每個欄位看起來都完整,整筆資料仍可能需要被攔下。
這裡要分清楚兩種工作。
資料驗證檢查紀錄是否符合已設定的限制,例如必要欄位是否缺漏、關係對象是否符合要求。推理則根據既有事實與明確定義,推導出尚未直接寫出的結論。兩者用途不同,不能混為一談。
例如,已知某家公司屬於資產管理公司,而模型又定義所有資產管理公司都屬於金融服務機構,推理工具就能據此補出它也是金融服務機構的分類。這類推導的可信程度,仍取決於原始事實與定義是否正確。
驗證也需要額外設計。以 OWL 為例,它採取開放世界假設,資料沒有記載某件事,不代表那件事為假。要檢查缺少必填資料等問題,通常需要另外搭配 SHACL 之類的限制驗證機制。
所以,不能期待建立本體之後,所有錯誤都會自動浮現。團隊仍然必須說清楚,哪些情況算錯、錯了之後如何處理。
大型語言模型的可靠性,可以沿著前面的三種成本來設計。
假設使用者問:這家供應商出問題,哪些客戶會受到影響?
這個問題至少要先釐清兩件事。客戶指的是簽約方、付款方,還是最終使用者?受到影響,又指交貨延遲,還是其他業務後果?
在這類應用中,可以把本體作為領域地圖,要求系統先確認概念,再沿著定義好的關係檢索證據。生成答案後,也可以把其中的主張拆開,檢查每一段關係是否有資料支持。
但這應該被視為系統設計目標,不能直接宣稱本體能保證答案真實。
概念定義正確,原始資料仍可能過期;推導符合規則,也不代表規則涵蓋了所有現實情況。邏輯一致與事實正確,必須分開檢查。
因此,AI 專案應該保留三種不同的答案狀態:
不要把這三種狀態都寫成同樣肯定的語氣。讓系統知道何時不能下結論,應該和讓它找到答案一樣重要。
支持本體的理由越充分,越需要主動測試它是否真的必要。
第一個是事實反問:這個問題真的需要本體嗎?
如果補一份欄位說明、整理識別碼,再加上資料庫限制就能解決,應先驗證這些做法。簡單方案能處理的問題,沒有必要額外擴大建模範圍。
第二個是商業反問:省下的成本,能否抵過維護負擔?
專案應把定義維護與爭議處理列入成本。誰決定兩個角色是否相同?業務規則改了,誰負責更新?若這些責任沒有人承擔,模型再完整,也難以持續支援日常決策。
第三個是方法反問:成效究竟來自本體,還是資料終於被整理好了?
試做時,應讓基礎方案與本體方案盡可能使用相同的資料,再比較回答時間和錯誤情況。若本體方案沒有帶來足以抵銷維護成本的增益,就應縮小範圍,甚至停止擴大。
這些反問能把專案從技術展示拉回業務驗證。
最適合的起點,是一個反覆出現、目前需要人工處理,而且做錯會付出代價的問題。
例如,先選定供應商停工對未交付訂單的影響查詢。只建立回答這個問題需要的概念與關係,遇到無關資料就暫時擱置。
試做前,先記錄現行流程的表現,再決定要改善什麼:
這些指標不需要一開始就漂亮,但必須能比較。
企業也可以先盤點既有工具,評估是否採購查詢、推理與驗證能力,再把內部投入集中在需要自行負責的業務定義上。工具怎麼選,應由問題與試做結果決定。
本體值得擴大的訊號,是團隊能用同一套定義穩定回答更多重要問題,同時減少人工解釋與追查。如果模型持續變大,回答品質卻沒有改善,就該重新檢查範圍與方法。
先找出企業最昂貴的理解錯誤,再決定要建立多少本體。這樣的起點,才有機會讓語義精準度變成可驗證的商業價值。
留言功能已關閉。

[…] 上一篇談的是哪些理解錯誤值得投入本體。接下來的工程問題,是如何把這筆投入控制在能交付、能維護的範圍內。 […]