Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

易輔科技
易輔科技
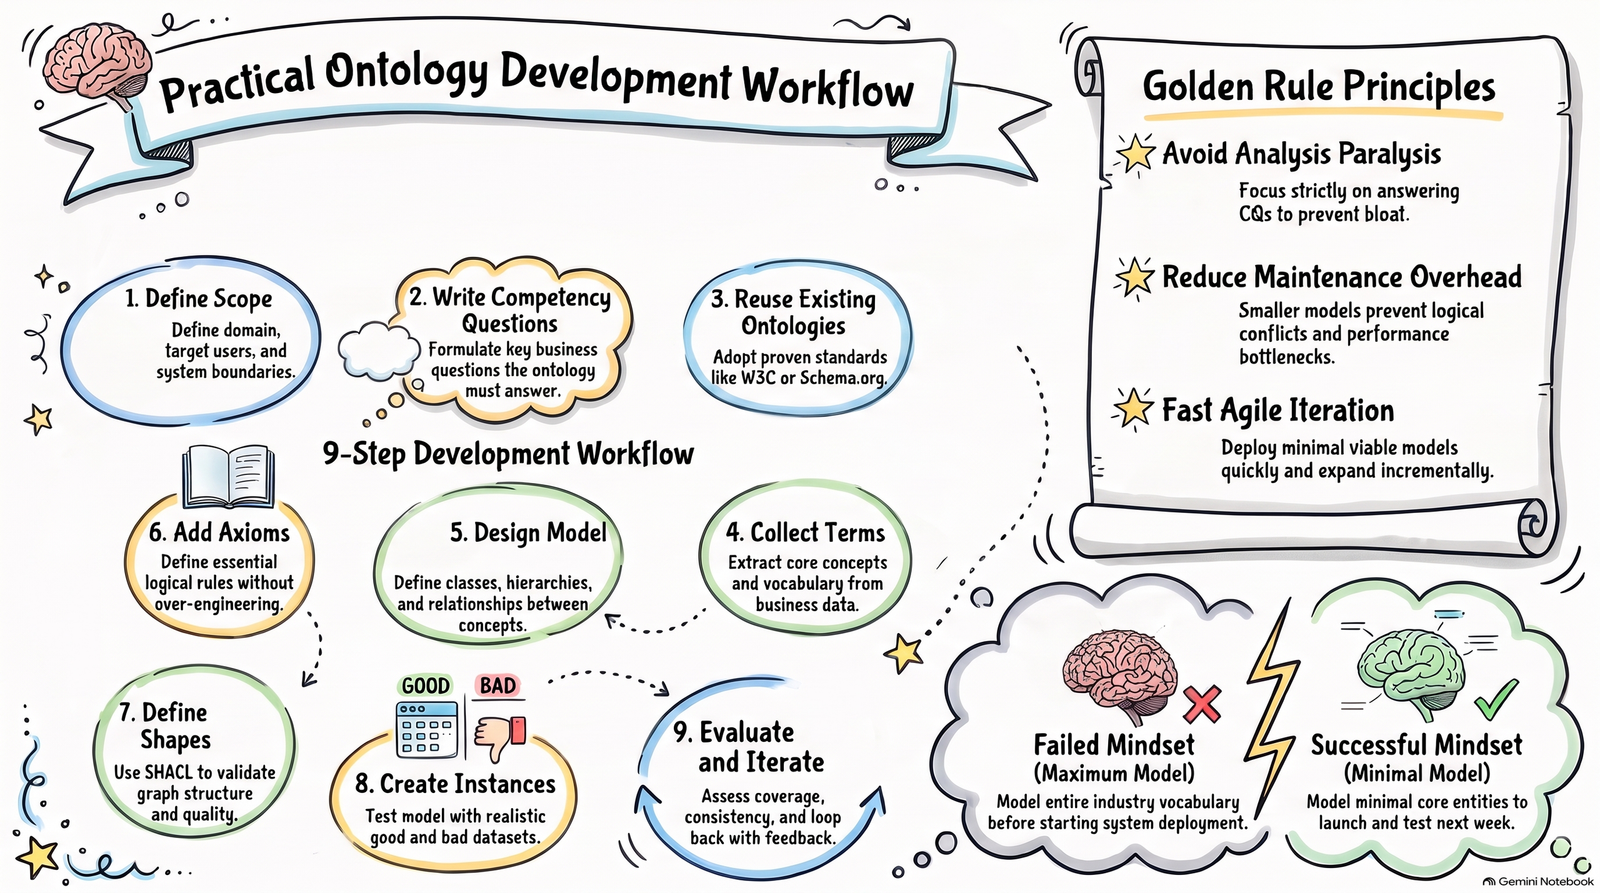
本體專案應該以一組可驗收的業務問題作為第一份交付物。團隊若還說不清楚系統必須回答什麼,就不該急著擴充類別與關係。每一項新增定義,都應該能說明它支援哪個問題,以及缺少它會造成什麼錯誤。
上一篇談的是哪些理解錯誤值得投入本體。接下來的工程問題,是如何把這筆投入控制在能交付、能維護的範圍內。
我建議用問題、承諾、證據這個三層框架管理開發:先寫出要回答的問題,再決定模型必須承擔哪些定義與邏輯,最後用實例證明它確實做得到。
九個開發步驟,都可以放進這三層裡。它們構成一個反覆修正的循環,過程中隨時可能回到前一步。史丹佛的《Ontology Development 101》也明確指出:
“Ontology development is necessarily an iterative process.”
本體開發必然是一個反覆修正的過程。
這句話的實務意義是,第一版模型應該儘早接受應用與領域專家的檢驗。後續修改是開發的一部分,無須等到所有定義都討論完才開始測試。
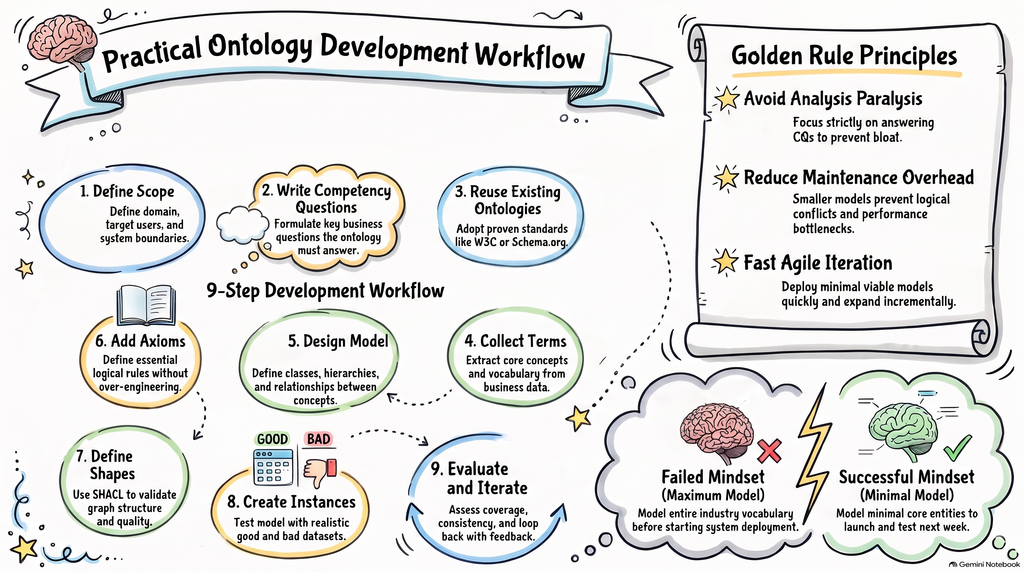
假設團隊要建立一套 ETF 資訊查詢服務,協助研究人員查明產品與相關機構的關係。
如果目標只寫成建立金融本體,範圍幾乎可以無限延伸。公司治理、交易制度,甚至整個資本市場,都有理由被納入。
第一步應先限定服務對象與使用情境。
這一版服務誰?支援什麼決策?使用哪些資料?哪些問題暫時不處理?
例如,可以先限定為研究人員查詢指定 ETF 的管理機構與追蹤指數,暫不處理持有人分析,也不提供投資建議。這個邊界讓團隊有依據拒絕暫時無關的需求。
第二步是撰寫勝任力問題(Competency Questions,簡稱 CQs),也就是這套知識系統必須有能力回答的問題。
《Ontology Development 101》將這類問題視為界定範圍的方法,也把它們當成後續檢查模型是否包含足夠資訊的試金石。
上述 ETF 服務,可以先寫出幾個問題:
最後一題尤其重要。找得到一個名稱,與能交代名稱的依據,是不同的驗收要求。
每個問題還應附上預期答案格式,以及資料不足時如何回應。例如,來源沒有記載有效日期,系統就應標示時間資訊不足,不能直接把最新取得的紀錄當成所有日期都成立的事實。
問題寫到這個程度,團隊才看得出模型需要什麼。
第三步是檢查既有本體與詞彙,看看哪些概念可以沿用。史丹佛的開發指南也把重用既有本體列為早期應評估的工作。
但採用既有概念之前,應先比較它的定義是否符合目前的問題。
如果外部詞彙中的某個機構角色,與內部業務使用的意思不同,就不能只因為名稱相近而直接套用。可以保留自己的概念,再明確描述兩者的對應關係;必要時,也應暫緩採用。
重用的目標,是減少不必要的自行定義。整套匯入後再勉強解釋差異,反而會增加負擔。
這一層結束時,團隊應該拿得出一份有邊界的問題清單,並知道每個問題需要哪些資料與定義。
確定問題後,才進入術語整理與模型設計。
第四步是從現有資料和業務文件中收集術語,再與使用者確認意思。此時應保留不同名稱與解釋上的歧異,不必急著把它們合併。
假設資料裡同時出現管理公司、發行機構與指數提供者,團隊需要確認它們各自在問題中扮演什麼角色。哪些名稱確實等義,哪些只是經常一起出現,都應留下判斷依據。
第五步才是定義類別、屬性與關係。這也是本體開發的基本工作:確定有哪些類別、如何形成分類層級,以及實例可以具備哪些屬性。
以這個假設案例來看,模型可能需要表達:
最後兩項提醒我們,最小模型不能只用類別數量衡量。若問題要求回答某個日期的情況,只留下 ETF、機構與指數三種類別,未必足夠。
精簡的標準,應該是每項設計都有用途,同時沒有刪掉可靠回答所需的資訊。
第六步是加入公理,也就是對概念與關係作出的正式邏輯陳述。
例如,若模型定義所有 ETF 都屬於基金,推理工具就能據此將某個 ETF 實例歸入基金類別。這類分類與一致性檢查,都是本體推理工具可以支援的工作。
但從資料觀察到的慣例,不能直接升格為普遍成立的規則。
假設目前資料中,每檔 ETF 都只記載一家管理機構。這足以讓團隊提出問題,卻還不足以證明任何情境下都只能有一家。不同時間的管理關係如何表達,也必須先處理。
每新增一項公理,建議附上三個說明:
回答不出來的公理,先不要加入。把尚未確認的業務假設寫進邏輯,會讓後續推導帶著同樣的假設繼續擴散。
第七步是定義資料驗證規則。
本體公理與資料驗證各有任務。前者描述概念及其邏輯關係;後者檢查送進來的紀錄,是否符合這個應用要求的條件。
SHACL 是 W3C 用來驗證 RDF 圖資料的標準。它可以用 Shapes 表達限制,例如某個屬性至少要有一個值、值必須符合指定型別,或關係對象必須屬於指定類別。
在這個示範專案中,團隊可以自行訂定資料接收要求:每筆追蹤關係必須附上來源,日期欄位必須符合指定格式。
這些要求應被標示為應用的驗證規則,避免被誤讀為整個金融領域都普遍成立的定義。若涉及合規,也必須確認哪些要求能轉成資料限制,哪些仍需其他審查程序。
第八步是建立實例,把模型放進具體情境。
測試資料不宜只放整理得很乾淨的紀錄。除了預期可接受的案例,也應準備違反規則的案例,以及目前無法確定答案的案例。
| 測試情境 | 預期行為 |
|---|---|
| 關係與來源完整,時間也符合查詢條件 | 回傳答案與依據 |
| 規定必須附來源,但紀錄缺少來源 | 產生驗證結果,依流程補件或隔離 |
| 兩份來源對同一期間有不同記載 | 標示衝突,交由既定程序處理 |
| 有管理機構名稱,但缺少有效期間 | 對指定日期的問題保留不確定性 |
這些是示範性的驗收設計,實際處理方式仍應由業務需求決定。
它們共同測試一件事:系統除了能回答,也必須能區分資料不足與資料衝突。
第九步是評估與修正。評估不應只留下好用或不好用的印象,應該能追到具體原因。
可以從四個面向驗收:
覆蓋率也要說明分母。若只測了刻意挑選的簡單問題,即使全部答對,也不能據此宣稱系統已能處理整個業務領域。
測試結果接著決定下一輪工作:資料缺漏就回到資料取得,定義不清就找領域專家確認,關係表達不足才擴充模型。不要把所有問題都轉成新增類別的需求。
最小且可靠,是好的開發方向。把它寫成小就一定比較好,仍然會誤導決策。
第一個是事實反問:模型小,就一定快嗎?
效能還取決於使用的邏輯表達、推理任務與資料規模。W3C 設計不同 OWL 2 Profiles,正是為了在表達能力與推理效率之間作出不同取捨;其中 OWL 2 EL 就特別面向包含大量類別或屬性的應用。
所以,模型變大不等於推理工具一定崩潰;模型縮小,也無法保證查詢速度。效能必須在實際工作負載下測量。
第二個是商業反問:精簡是否把成本移到人工處理?
若為了減少關係,把來源與時間資訊都省掉,研究人員可能每次查詢後仍要自行查證。模型看起來輕巧,流程卻沒有變輕。
應計算整個使用流程的成本,包含例外處理與人工補查。
第三個是方法反問:問題清單是否只挑模型擅長回答的題目?
CQs 能約束範圍,也可能形成盲點。若驗收問題全由開發團隊挑選,就應另外請使用者提供未參與建模的案例,檢查模型是否只記住了示範情境。
小模型的價值,要靠這些壓力測試證明。
本體開發可以先訂一個簡單的變更原則:每新增一個類別、關係或公理,都必須指出它支援哪個問題,並附上能驗證用途的案例。
這不代表沒有立即用途的設計一律刪除。若某項設計是為了資料交換或後續擴充,也應寫明理由,讓團隊知道自己正在承擔什麼成本。
每輪開發結束前,檢查五件事:
先交付能接受檢驗的模型,再依新問題擴充。模型規模應該是解題需求累積的結果;每一次成長,都要能交代它替使用者多解決了什麼。