Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124
Physical Address
304 North Cardinal St.
Dorchester Center, MA 02124

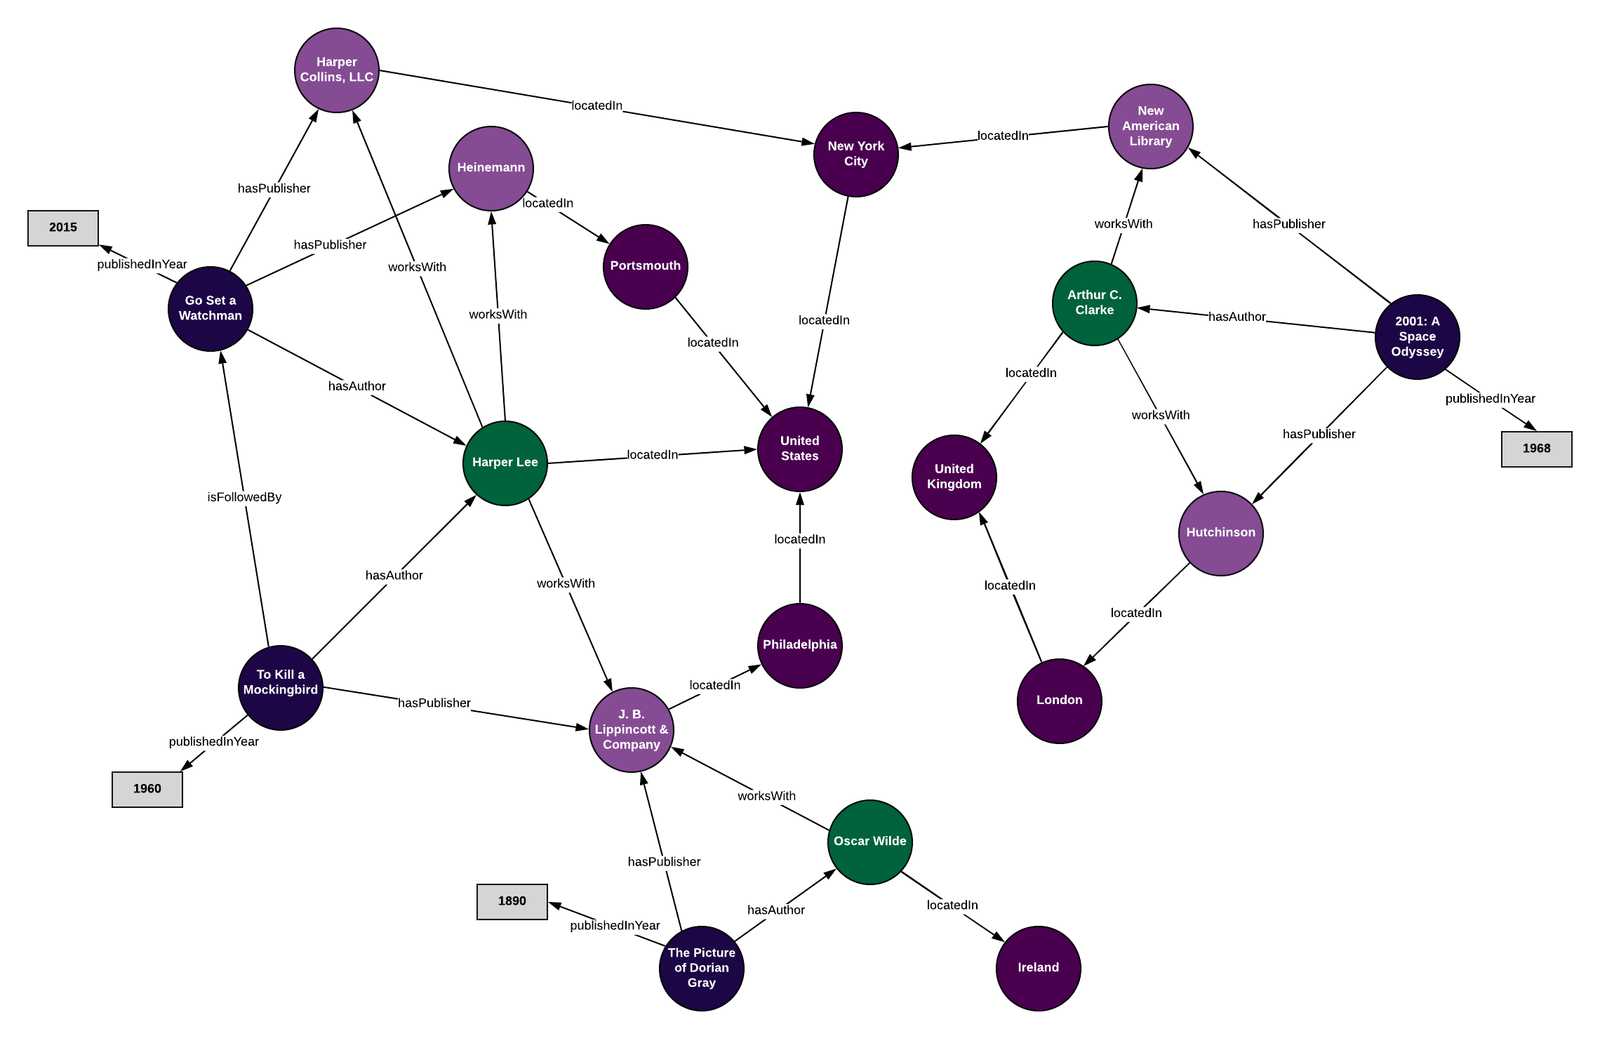
知識圖譜負責儲存與查詢具體事實,
本體論負責定義這些事實應該如何被理解。
企業若只建知識圖譜而缺乏本體論,容易得到一張連結很多、語意卻不一致的圖;若只做本體論而沒有可查詢的資料層,則容易停留在文件與模型,無法支撐實際決策。
真正的問題因此不在於該選知識圖譜或本體論,而在於如何讓兩者以低成本、可迭代的方式共同運作。這正是現代資料架構的關鍵:把語意模型與資料儲存分開,讓企業能直接在既有資料倉儲或資料湖上查詢關係,避免為了建立圖譜而複製資料、重建管線。
知識圖譜是一種以圖形結構表示真實世界實體與關係的資料模型。節點代表客戶、產品、帳戶、供應商或事件;邊代表它們之間的關係,例如擁有、隸屬、依賴或交易;節點與邊還可以附加屬性,記錄時間、金額、狀態或其他脈絡。PuppyGraph 對知識圖譜的定義也強調,它透過實體、關係與屬性,把分散資料組織成可理解、可推論的知識基礎。
這種結構的價值,來自它讓資料能以關係為中心被查詢。傳統關聯式資料庫擅長儲存結構化紀錄,但當問題變成「這個客戶與哪些帳戶、裝置、供應商或風險事件有間接關聯」時,多層關聯往往會變得難以維護。知識圖譜則把這類問題轉成圖形走訪:從一個節點出發,沿著關係找到相連的實體與路徑。
知識圖譜通常有幾個特徵:
例如,在詐欺偵測場景,知識圖譜可以把帳戶、裝置、IP、交易與受益人連起來。當系統發現多個帳戶共用同一組裝置或地址,就能把原本分散在不同系統的風險訊號,轉成可調查的關聯網絡。PuppyGraph 也將詐欺與金融犯罪列為典型應用,透過帳戶、裝置、交易與資金流向的連結,協助調查協同詐欺與資金路徑。
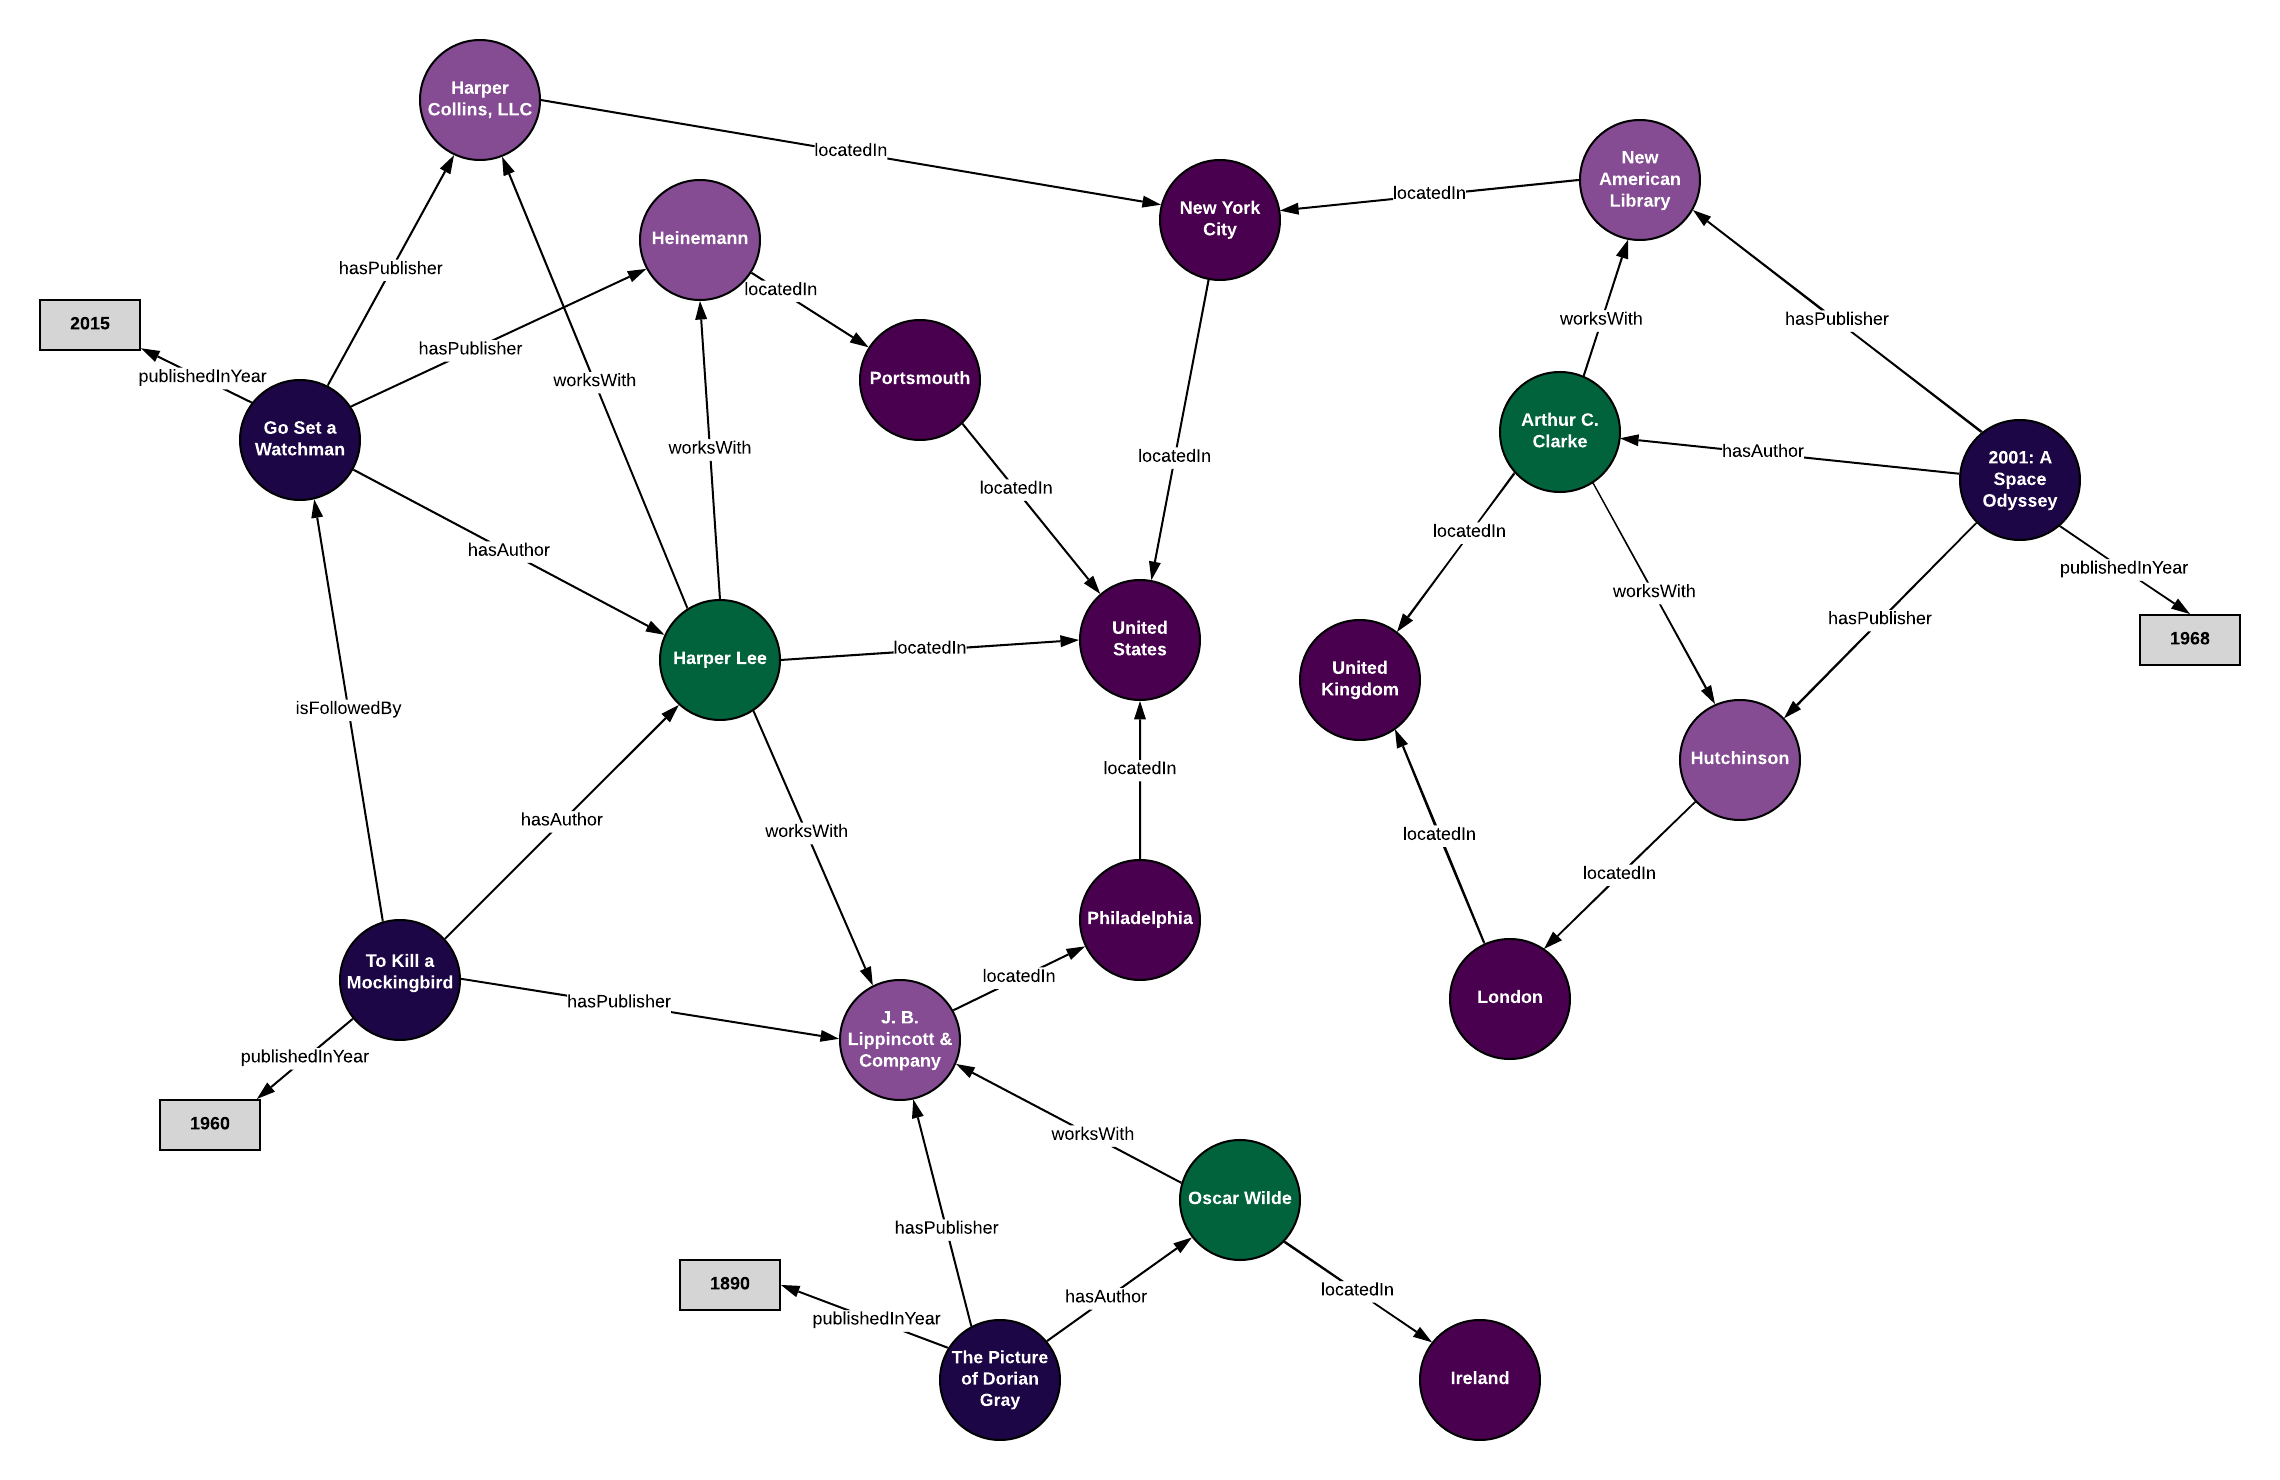
本體論是一份正式、明確的領域語意模型。它定義一個領域中有哪些類型的東西、這些東西有哪些屬性、彼此能建立什麼關係,以及哪些規則應該被遵守。它的角色像是一份共用詞彙與商業規則的藍圖,讓不同團隊、系統與資料來源對同一個概念有一致理解。
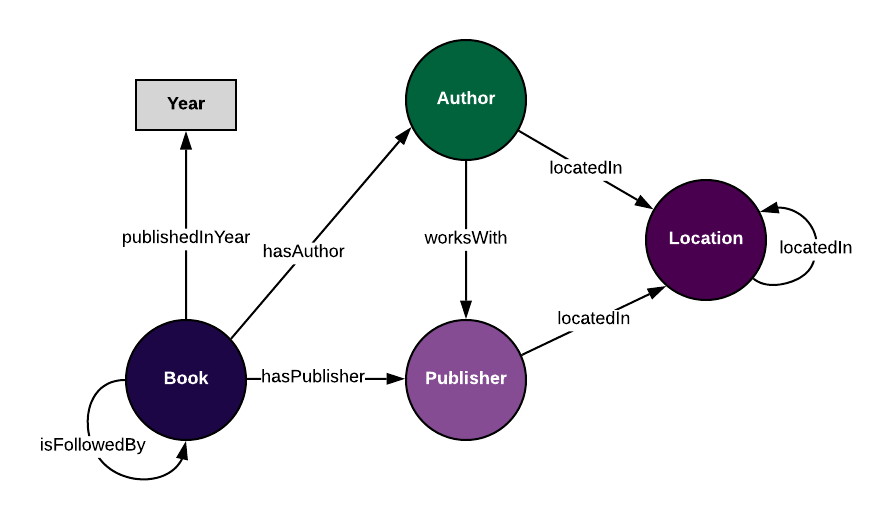
Enterprise Knowledge 將本體論描述為語意資料模型,定義領域中存在的類型與描述它們的屬性;它處理的是一般化的類別,例如書籍、作者、出版社與地點,而非某一本特定書的資料。 這正是本體論與知識圖譜最重要的分工:本體論回答「什麼是客戶、訂單、供應商與風險事件」,知識圖譜則記錄「哪一位客戶在哪一天下了哪一筆訂單」。
本體論通常包含三個部分:
本體論的強項在於語意一致性與推論。若模型定義「所有員工都是人」,而系統知道 Alice 是員工,推理引擎就能推論 Alice 也是人。這類能力在醫療、生命科學、法規遵循與主資料管理特別有價值,因為這些領域對術語、層級與規則的一致性要求很高。
但本體論也有代價。它需要領域專家共同設計,且核心概念一旦改動,可能影響多個下游系統。因此,本體論通常相對穩定,變更週期較長;知識圖譜則更接近營運資料,會隨新事件、新關係與新來源持續擴張。
| 面向 | 知識圖譜 | 本體論 |
|---|---|---|
| 主要目的 | 儲存並查詢具體事實與關係 | 定義概念、語意、規則與限制 |
| 抽象層級 | 實例層,例如某位客戶、某筆訂單 | 概念層,例如客戶、訂單的定義 |
| 典型內容 | 節點、邊與屬性 | 類別、屬性、關係與公理 |
| 變更節奏 | 隨資料持續更新 | 相對穩定,變更需較多治理 |
| 推理角色 | 可支援,但取決於底層語意模型 | 以正式語意與邏輯推論為核心 |
| 常見技術 | 屬性圖、RDF、Cypher、Gremlin、SPARQL | OWL、RDF Schema、受控詞彙與領域模型 |
一個實用的判斷是:知識圖譜回答「現在發生了什麼」,本體論回答「這件事在領域裡代表什麼」。前者提供可操作的資料層,後者提供可共用、可治理的語意層。Enterprise Knowledge 也把兩者關係濃縮為:本體論加上資料,形成知識圖譜。
ontology + data = knowledge graph
單獨使用知識圖譜,常見風險是語意漂移。不同團隊可能都建立「客戶」節點,但一個團隊指的是自然人,另一個團隊指的是企業帳戶;「供應商」可能同時被用來表示供貨商、經銷商或外部服務提供商。圖譜愈大,這種不一致就愈難修復。
單獨使用本體論,則容易變成一份漂亮但難以執行的模型。若沒有把實際資料映射進來,也沒有高效能的查詢層,本體論無法回答營運問題,例如某供應商中斷後,哪些產品、客戶與訂單會受影響。
較健全的架構,是把本體論當作語意骨幹,把知識圖譜當作可查詢的資料層。本體論確保客戶、訂單、產品、供應商與風險事件的定義一致;知識圖譜則把實際紀錄填入這個模型,讓分析師、應用程式與 AI 代理能沿著關係查詢。
這也改變了 AI 系統的設計方式。對 GraphRAG 或企業 AI 代理而言,模型不能只依賴向量相似度,還需要知道哪些實體與關係是合法的。PuppyGraph 主張,透過明確的圖譜模型,AI 代理可以依據已定義的實體與關係查詢;無效的實體或關係參照會被拒絕,並回饋給代理修正查詢。 這代表本體論不只是資料治理文件,也能成為 AI 查詢的護欄。
概念上,本體論加資料等於知識圖譜;實務上,難點在於如何讓模型與資料持續同步。
傳統做法通常需要三個步驟:先設計本體論或圖譜模式,再把關聯式資料轉換成圖形格式,最後載入專用圖形資料庫。這條路徑會帶來幾個問題:
這些問題讓許多知識圖譜專案停在概念驗證階段。真正需要的,是讓企業能在既有資料上定義語意模型,並直接以圖形方式查詢,而不必把資料搬進另一個系統。
PuppyGraph 採取的做法,是把圖形查詢層放在既有資料系統之上。它讓團隊以宣告式 JSON 定義節點類型、邊類型,以及它們對應到底層資料表與鍵值的方式;同一份來源資料,可以透過不同圖譜模式,被解讀成不同的語意視角。
這個設計把兩件事分開:語意建模與資料儲存。團隊可以先定義一個較小的圖譜模型,驗證業務問題是否有價值;等理解加深後,再調整模型或新增關係,而不需要重建資料管線或搬移資料。
PuppyGraph 官方將自身定位為圖形查詢引擎,而非圖形資料庫。資料保留在既有資料倉儲、資料湖或資料庫中,透過 openCypher 或 Gremlin 查詢,不需要建立第二份圖形資料副本。 這對企業的意義很具體:資料治理、存取控制與資料新鮮度,仍可維持在既有平台;圖譜能力則以查詢層的形式加入。
其宣稱的能力包括:
需要區分的是,這些屬於供應商的產品宣稱與客戶見證。PuppyGraph 網站「宣稱」可在 10 分鐘內完成首次查詢、支援 10 跳、數十億邊的次秒級查詢,並已在生產環境處理 5 至 10 PB 資料;這些數字應視為供應商宣稱,實際效能仍取決於資料量、查詢模式、硬體、來源系統與網路延遲。
若你的問題是資料分散、需要找出跨系統的關聯,先建立知識圖譜。例如資安團隊要追蹤身分、權限、資產與攻擊路徑;供應鏈團隊要追蹤供應商、原料、產品與下游客戶;風控團隊要追蹤帳戶、裝置、交易與受益人。
若你的問題是術語不一致、跨部門協作困難、法規遵循或需要自動推論,先建立本體論。例如醫療機構需要統一疾病、處置與藥品的定義;製造業需要統一產品、物料、供應商與工廠的層級關係。
若你要建立可長期營運的語意資料平台,兩者都要有,但要控制投入順序:
知識圖譜與本體論並非競爭技術。知識圖譜負責把具體事實與關係變成可查詢的資料層;本體論負責讓這些事實有一致、可推論、可治理的語意基礎。企業真正該避免的,是把兩者混為一談,或為了建立圖譜而複製資料、重建管線。
更務實的路徑,是讓本體論成為可迭代的語意層,讓知識圖譜成為直接查詢既有資料的方式。當企業能不搬資料、不建第二份圖譜副本,就能更快驗證哪些關係真的具有商業價值,也能讓 AI 代理在明確的語意邊界內取得連結脈絡。這才是知識圖譜從概念走向生產環境的關鍵。